Together AI stellt Compiler zur kontinuierlichen Optimierung von KI-Inferenz vor
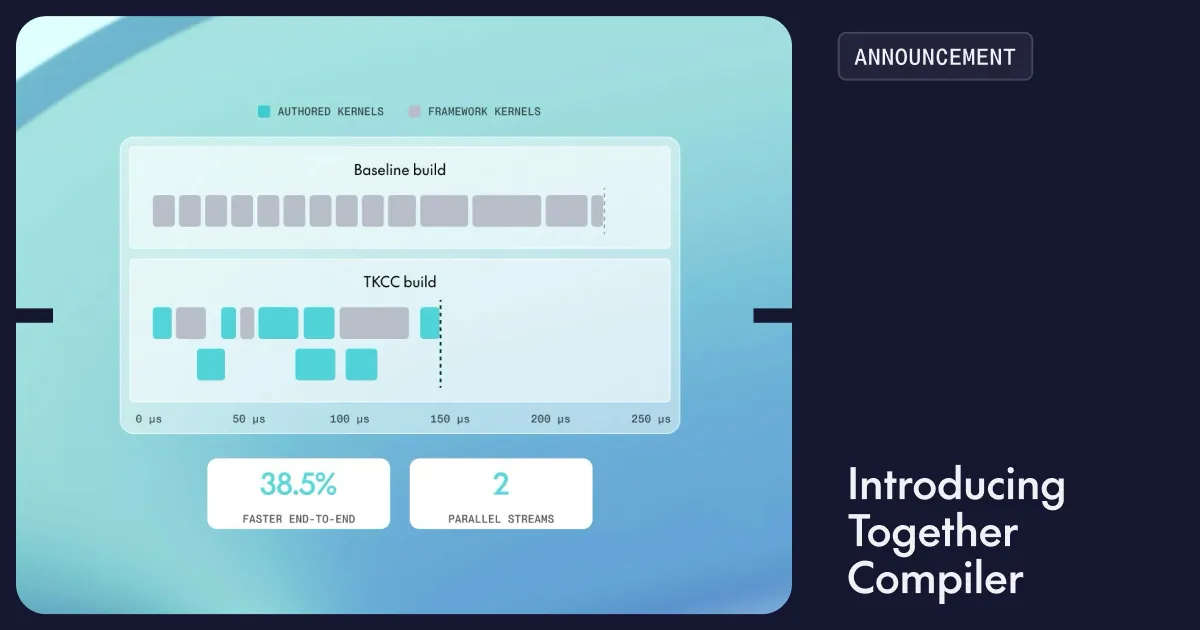
Together AI hat den Together Compiler vorgestellt, ein kontinuierliches Kompilierungssystem zur Optimierung von KI-Inferenz, wenn sich Modelle, Hardware und Kundenverkehr ändern. Nach Angaben des Unternehmens erreicht das System bei mehreren hochmodernen Open-Source-Modellen in weniger als 24 Stunden eine 1,3- bis 3-fach höhere TPS-Leistung.
- Der Together Compiler optimiert KI-Inferenz mithilfe von Agenten kontinuierlich.
- Together AI meldet eine 1,3- bis 3-fach höhere TPS-Leistung bei mehreren hochmodernen Open-Source-Modellen.
- Das System nutzt persistente Engines und reduziert die gemeldete Zeit für die Einrichtung des Servings auf 9,0 Sekunden.
- TKCC meldet 1111 TPS bei MiniMax M3.1-Flash und 1205 TPS bei DeepSeek v4.1-Flash.
- Together AI zufolge funktioniert der Compiler auch bei Arbeitslasten für Wettermodelle, partielle Differentialgleichungen, Zeitreihen und Biologie.
Ein Compiler für wechselnde Arbeitslasten
Nach Angaben von Together AI umfassen Inferenz-Arbeitslasten inzwischen Tausende von Kombinationen aus Modellen, Hardware-Plattformen, Kunden, Anwendungsfällen und Verkehrsmustern. Das Unternehmen verarbeitet täglich viele Billionen Tokens für Tausende Kunden. Deren Arbeitslasten können sich bei Batch-Größe, Sequenzlänge, Ungleichgewicht bei Mixture-of-Experts, Aufmerksamkeits-Sparsamkeit, Sitzungsdauer und Domäne unterscheiden.
Der Together Compiler, auch TKCC genannt, verarbeitet die Verkehrsform, das Modell und die Hardware einer Arbeitslast als Eingaben. Anschließend setzt er mehrere Agenten ein, um Optimierungen für eine Inferenz-Engine zu erzeugen und zu testen. Together AI bezeichnet TKCC als das erste kontinuierliche RSI-System für diese Aufgabe. Das bedeutet, dass es seine Optimierungsentscheidungen bei veränderten Bedingungen wiederholt untersuchen, durchsuchen und verbessern kann.
Das System soll eine große Bandbreite an Hardware unterstützen, darunter H100s, B200s, B300s, NVL72, VR- und Groq-Plattformen. Together AI zufolge lässt sich TKCC außerdem über die Inferenz von Sprachmodellen hinaus auf Wettermodelle, partielle Differentialgleichungen, Zeitreihen-Arbeitslasten und Biologie verallgemeinern.
Persistente Engines beschleunigen Experimente
Ein zentraler Bestandteil von TKCC ist der Einsatz persistenter Engines. Statt Systeme wie vLLM, SGLang oder TRT-LLM für jedes Experiment wiederholt zu starten und herunterzufahren, wird die Engine einmal gestartet und lädt Kandidaten für Forward Passes im laufenden Betrieb neu, ohne einen Neustart.
Nach Angaben von Together AI benötigt der herkömmliche Prozess in seinem Vergleich 467 Sekunden bis zum Erreichen des Servings. Darin enthalten sind das Laden der Gewichte, die Dimensionierung des KV-Caches, das Aufwärmen der JIT-Kernels und das automatische Tuning. Der Together Compiler benötigt in derselben Tabelle 9,0 Sekunden. Das Unternehmen erklärt, dass dieses Design einen um den Faktor 252 höheren Experimentdurchsatz als agentische RSI-Systeme zur Optimierung der Inferenzleistung im Ausgangszustand ermöglicht und die GPU-Leerlaufzeit während der Arbeit der Agenten reduziert.
TKCC nutzt außerdem eine Engine-Hierarchie, um schnelle Experimente mit realistischen Messungen auszubalancieren. Schnelle Engines laden wenige Layer für eine rasche Zeitmessung mit geringer Varianz, während langsamere Engines viele Layer laden, um Optimierungen anhand realer Datenverteilungen zu testen. Das ist für Architekturen mit datenabhängigem Verhalten wichtig, etwa Mixture-of-Experts und Sparse Attention.
Gemeldete Ergebnisse bei Modellen und in verschiedenen Domänen
Together AI zufolge erzielte TKCC bei der Arbeitslast Llama 1B mit Batch-Größe 1 eine 1,7-fach höhere TPS-Leistung als verfügbare Open-Source-Megakernels. Beim InferenceX-AgentX-Benchmark von SemiAnalysis meldet das Unternehmen eine 1,3- bis 3-fach höhere TPS-Leistung als hochoptimierte Basiskonfigurationen über hochmoderne Modelle, Inferenz-Engines und Hardware-Plattformen hinweg.
Für Tests mit niedriger Latenz und Batch-Größe 1 meldet Together AI 1111 TPS bei MiniMax M3.1-Flash und 1205 TPS bei DeepSeek v4.1-Flash. Nach Angaben des Unternehmens setzen diese Ergebnisse den Stand der Technik beim InferenceX-Benchmark von SemiAnalysis. In der breiteren Auswertung nennt Together AI außerdem Kimi K3, GLM 5.3 und DeepSeek v4.1-Flash als verwendete Modelle.
Together AI zufolge verarbeitet TKCC bereits Billionen von Tokens. Der Ansatz soll sich weiter anpassen, wenn sich der Verkehr verändert, etwa durch längere Prompts nach der Veröffentlichung von Modellen, regionale Unterschiede bei den Prompt-Längen und plötzliche Anfrage-Spitzen, die sich auf die Cache-Trefferraten auswirken können. Für Anbieter und Nutzer von Inferenzdiensten könnte darin ein System liegen, das Bereitstellungen kontinuierlich abstimmt, statt sich auf eine manuell optimierte Konfiguration zu verlassen.
Together AI: Together Compiler: Continuous Compilation for AI inference