Together AI stellt selbstoptimierenden Ansatz für Inferenz mit offenen Modellen vor
Together AI hat Polymorphic Inference vorgestellt, einen selbstoptimierenden Ansatz, der die Bereitstellung offener Modelle an veränderte Architekturen, Workloads und Hardware anpasst. Das Unternehmen kündigte außerdem an, dass Together Compiler im Produktivbetrieb läuft und die Inferenzleistung kontinuierlich optimiert.
- Together AI hat Polymorphic Inference für sich verändernde Modelle, Workloads und Hardware vorgestellt.
- Nach Angaben des Unternehmens entfallen 80% des OpenRouter-Datenverkehrs auf Modelle, die in den vergangenen drei Monaten veröffentlicht wurden.
- Together Compiler setzt KI-Agenten ein, um nach Optimierungen für die Inferenz zu suchen.
- Together Compiler läuft auf ausgewählten serverlosen Endpunkten im Produktivbetrieb.
- Das Tool ist für Endkunden in einer begrenzten Beta verfügbar.
Inferenz, die ihre Form verändern kann
Together AI beschreibt Polymorphic Inference als Inferenz in „vielen Formen“. Der Ansatz ist eine Reaktion auf die schnellere Veröffentlichung quelloffener Modelle und die wachsende Vielfalt ihrer Einsatzmöglichkeiten. Nach Angaben des Unternehmens entfallen 80% des Datenverkehrs auf OpenRouter auf Modelle, die in den vergangenen drei Monaten veröffentlicht wurden. Das verdeutlicht, wie schnell sich Inferenzsysteme anpassen müssen.
Der Ansatz trägt auch der architektonischen Vielfalt Rechnung. Laut Together AI verwenden alle zehn derzeit meistgenutzten quelloffenen Modelle unterschiedliche Architekturen. Der Datenverkehr kann sich verändern, wenn sich Produkte, Nutzerverhalten, geografische Regionen und Service-Level-Vereinbarungen wandeln. Auch das Post-Training von Modellen kann beeinflussen, wie viele Tokens ein System für Aufgaben wie das Schlussfolgern verwendet.
Auch die Hardware entwickelt sich weiter. Together AI verweist auf Veränderungen bei den Möglichkeiten für die Inferenzbereitstellung von B200 zu GB300 und erklärt, dass sich die Branche den ersten Vera-Rubin-Einsätzen nähert. Parallel dazu verändern sich CPUs, Speichersysteme und alternative Inferenzchips.
Warum statische Optimierung nicht ausreicht
Together AI stellt Polymorphic Inference dem sogenannten „Static Inference“ gegenüber. Dabei handelt es sich um ein früheres Bereitstellungsmodell, das auf geschlossenen Modellen, traditionellen Transformer-Architekturen, Workloads mit einem einzelnen Nutzer und einer einzigen Hardwareplattform basiert. In diesem Umfeld konnte eine Inferenz-Engine auf eine Konfiguration zugeschnitten werden und sollte anschließend konstant leistungsfähig bleiben.
Das Unternehmen hält diese Annahme zunehmend für unzuverlässig. Eine Konfiguration, die für einen Workload optimiert wurde, muss nicht die beste Wahl für einen anderen sein. Zudem können quelloffene Kernel, die auf festen Datenverkehrsprofilen basieren, schlecht zum Datenverkehr im Produktivbetrieb passen. Als Beispiel nennt Together AI Kernel für Mixture-of-Experts-Modelle und erklärt, dass sich die Leistung bei zufälligen Tokens möglicherweise nicht auf reale Produktionsumgebungen übertragen lässt.
Das Unternehmen erklärt außerdem, seine Erfahrungen mit der Bereitstellung von Megakernels hätten seine Einschätzung des besten Optimierungsziels verändert. Ein Megakernel kann auf eine statische Form ausgelegt werden, etwa auf eine Batch-Größe von eins für Llama 1B. Together AI argumentiert inzwischen jedoch, dass Modellarchitekturen und Workloads unterschiedliche technische Ansätze erfordern.
Together Compiler ermöglicht kontinuierliche Optimierung
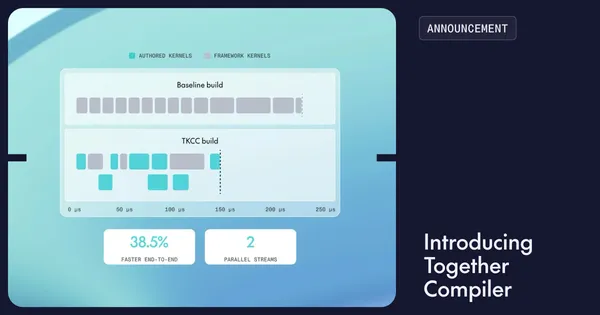
Together Compiler wird als frühe Umsetzung der Polymorphic-Inference-Strategie des Unternehmens vorgestellt. Together AI beschreibt das System als schnelle, KI-gestützte Schleife zur Leistungsoptimierung, die die Optimierung von Inferenz von einer traditionellen Aufgabe der Compiler-Übersetzung in ein agentisches Suchproblem verwandelt.
Das System erkennt zentrale Optimierungsmuster und kombiniert ein Schwarm-Setup aus Agenten mit einer persistenten Engine für schnelle Iterationen. Nach Angaben von Together AI treibt Together Compiler bereits Optimierungsschleifen für Continuous Compilation über viele der wichtigsten Inferenz-Workloads im Produktivbetrieb an. Das System läuft auf einigen der beliebtesten serverlosen Endpunkte und hat dort zusätzliches Potenzial auf bereits optimiertem Code erschlossen.
Nach Angaben des Unternehmens kann dieser Ansatz den Bedarf verringern, bei Veränderungen der Datenverkehrsprofile oder Workloads neue handgeschriebene Kernel und Optimierungen zu entwickeln. Together Compiler ist für Endkunden heute in einer begrenzten Beta verfügbar. Das Unternehmen erklärt, Kunden könnten das Tool schon bald nutzen, um dedizierte Endpunkte für ihre eigenen Modelle, Engines, Datenverkehrsprofile und Anwendungsfälle zu optimieren.
Together AI gibt außerdem einen Ausblick auf Arbeiten an formverändernder spekulativer Dekodierung, dynamischem Routing über heterogene Bereitstellungen hinweg durch ThunderAgent Router sowie auf weitere Forschung, die durch die Verarbeitung von Billionen Tokens pro Tag geprägt ist. Für Nutzer offener Modelle besteht das erklärte Ziel in einer Inferenz, die sich schneller an Veränderungen bei Modellen, Anwendungen und Rechenplattformen anpassen kann, anstatt auf einer einzigen festen Konfiguration zu beruhen.
Together AI: Polymorphic Inference: self-tuning inference for open models