Google testet günstigen Klassifikator zur Weiterleitung von Gemini-Aufgaben und Senkung der Agentenkosten
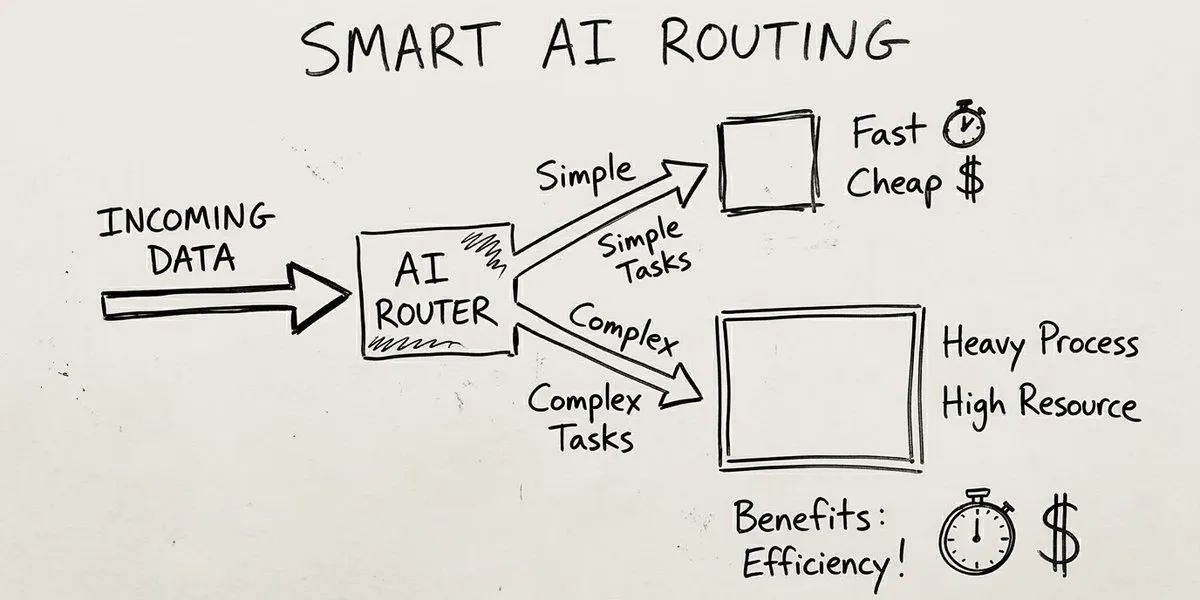
Googles Entwicklerblog argumentiert, dass inzwischen die Kosten pro erfolgreicher Aufgabe und nicht der Preis pro Million Tokens über die Wirtschaftlichkeit von Coding-Agenten entscheiden. In einem Benchmark mit 50 Fragen löste ein leichter Klassifikator, der zwischen Gemini Flash-Lite und Gemini 3.8 Flash mit niedrigem Denkaufwand weiterleitete, jede Aufgabe.
- Googles Entwicklerblog zufolge bestimmen die Kosten pro erfolgreicher Aufgabe und nicht der Preis pro Million Tokens inzwischen die Wirtschaftlichkeit von Agenten.
- Ein Jev-Klassifikator, der zwischen Flash-Lite und Gemini 3.8 Flash mit niedrigem Denkaufwand weiterleitete, löste alle 50 Benchmark-Aufgaben.
- Eine eingefrorene Schlüsselwort- und Längenheuristik fiel bei 34 unbekannten Aufgaben von 93,8 auf 70,6 Prozent, während Jev bei allen 34 übereinstimmte.
- Die Begrenzung von maxOutputTokens auf 300 senkte die Denkkosten bei einfachen Aufgaben nicht und führte bei 7 von 25 schwierigen Aufgaben zu Fehlern.
- Google erklärt, dass keine Partnerschaft mit TypeSafe besteht und die Ergebnisse aus Einzelmessungen stammen.
Kosten pro Aufgabe als entscheidende Kennzahl
Laut dem Beitrag von Sergio Villani von Google Cloud AI sinken die API-Preise pro Token weiter, während die Entwicklungskosten für autonome Coding-Agenten steigen. Der Autor bezeichnet die Kosten pro erfolgreicher Aufgabe als die Kennzahl, die inzwischen die Produktionsökonomie bestimmt: die Gesamtausgaben für jede Schleifeniteration, jeden Tool-Aufruf, jeden Wiederholungsversuch und jeden internen Denkdurchlauf, geteilt durch die Zahl der Aufgaben, die die Überprüfung bestehen.
Das Problem besteht dem Beitrag zufolge darin, dass Agenten für jede Mikroentscheidung häufig eine Konfiguration mit hohem Denkaufwand aufrufen. Damit zahlen sie Preise für tiefgehendes Schlussfolgern, obwohl eine leichtere Konfiguration die Fragen bereits präzise beantwortet. Die vorgeschlagene Lösung ist eine leichte Weiterleitungsschicht, die routinemäßige Entscheidungen abfängt, bevor sie ein teures Modell erreichen.
Das Beispiel nutzt den Jev-Klassifikator von TypeSafe vor den Modellaufrufen von Google Antigravity. Jev wird als spezialisierter Klassifikator für strukturierte Ausgaben beschrieben, der in einem einzigen Vorwärtsdurchlauf eine Choice aus einer Liste, einen numerischen Score oder einen Noul bewertet, also eine Wahrscheinlichkeit zwischen 0 und 1 für eine binäre Aussage. Google erklärt, dass keine Partnerschaft mit TypeSafe besteht und der Artikel keine Empfehlung darstellt. Dasselbe Muster lässt sich mit anderen Klassifikatoren umsetzen, darunter auch Google-eigenen wie jenem im Codelab Getting started with discriminative models, das auf DiffusionGemma, dem Open-Weights-Modell von Google DeepMind, läuft.
Warum einfache Heuristiken nicht ausreichten
Der erste Versuch nutzte eine einzige umfassende Choice-Frage: einfach oder komplex. Bei 16 Aufgaben für Coding-Agenten leitete Jev fast alles an „einfach“ weiter, auch Aufgaben, die eine LRU-Cache-Nachverfolgung oder modulare Exponentiation erforderten. Der Ersatz durch eine einzelne atomare Noul-Frage behob die Trennung. Bei diesen 16 Aufgaben stimmte Jev im ersten Durchlauf bei 13 von 16 mit der von Menschen markierten Schwierigkeit überein, im zweiten Durchlauf bei 14 von 16.
Das Team testete außerdem eine Python-Heuristik ohne Kosten, die Wörter wie sequence, modulo und race condition abglich und jede Eingabe mit mehr als 35 Wörtern eskalierte. Bei den Fragen, mit denen sie erstellt worden war, erreichte sie 15 von 16 beziehungsweise 93,8 Prozent. Nach dem Einfrieren des Codes und der Ergänzung um 34 unbekannte Testaufgaben aus sieben Kategorien sank der Wert um 23,2 Prozentpunkte auf 70,6 Prozent.
- Einfache Aufgaben, etwa das Extrahieren eines Ports aus einem Kubernetes-YAML-Manifest oder einer Zeilennummer aus einem Python-Traceback, überschritten 35 Wörter und wurden fälschlich eskaliert.
- Kurze Abläufe mit mehreren Schritten, etwa veränderliche Standardargumente über mehrere Aufrufe hinweg oder die Kurzschlussauswertung in C, enthielten die fest codierten Rätselwörter nicht und wurden auf den einfachen Pfad geschickt.
Jev klassifizierte alle 34 unbekannten Aufgaben übereinstimmend und kam damit über die gesamte Testsuite auf 48 von 50 beziehungsweise 96,0 Prozent.
Ausgabelimits verringern den Denkaufwand nicht
Der Beitrag warnt davor, anzunehmen, dass ein niedriger Wert für maxOutputTokens ein Reasoning-Modell bei einfachen Aufgaben weniger denken lässt. Beim Vergleich von gemini-3.8-flash mit maxOutputTokens=300 und demselben Modell mit 4096 verbrauchten beide bei den 27 von Jev als SIMPLE eingestuften Aufgaben nahezu gleich viele Denktokens. Die begrenzte Version kostete bei einfachen Aufgaben geringfügig mehr und scheiterte bei 7 der 25 schwierigen Aufgaben: In sechs Fällen ging dem Modell beim Schlussfolgern der Platz aus, im siebten komprimierte es seine Überlegungen und antwortete falsch.
Ein Jev-Router, der das begrenzte Modell für einfache Aufgaben und normales Flash für schwierige Aufgaben nutzte, löste alle 50 Aufgaben korrekt, war aber etwas teurer und langsamer als reines Flash. Die Schlussfolgerung des Autors: Wenn die günstige Option das Modell nicht weniger denken lässt, kann kein Router Geld sparen.
Die stärkste Ausgangsbasis und was sie übertraf
In einer zweiten Runde wurden Flash-Lite, das standardmäßig nicht denkt, und Gemini 3.8 Flash mit niedrigem Denkaufwand getestet. Die stärkste Konfiguration ohne Router war Gemini 3.8 Flash mit niedrigem Denkaufwand: Sie löste alle 50 Aufgaben.
Der Jev-Router schickte jede Aufgabe zunächst an Flash-Lite und eskalierte nur, was Jev als komplex markierte. Auch damit wurden alle 50 Aufgaben gelöst. Flash-Lite allein beantwortete jede einfache Aufgabe in einer halben Sekunde, verfehlte aber 6 der 25 schwierigen Aufgaben. Jev markierte alle 6 mit hoher Zuversicht als komplex. Dem Beitrag zufolge kann der Router gegenüber niedrigem Denkaufwand für alle Aufgaben Kosten und Antwortzeit senken. Bei kurzen Eingaben ist der Kostenunterschied pro Aufgabe jedoch gering, sodass die kürzere Wartezeit für interaktive Agenten der größere Vorteil ist.
Die Schlüsselwort-Heuristik war nur deshalb günstiger, weil sie Fehler machte: Sie schickte 5 schwierige Aufgaben an Flash-Lite, wobei 2 scheiterten, und kam damit auf 48 von 50. Schwierige Aufgaben an Flash mit standardmäßigem Denkaufwand zu eskalieren, kostete weniger als standardmäßiger Denkaufwand für alle Aufgaben, aber mehr als niedriger Denkaufwand für alle. Ein aufwendigeres Zielmodell für die Eskalation ist nur sinnvoll, wenn die Einstellung mit niedrigem Denkaufwand zunehmend scheitert.
Was das für Entwickler von Agenten bedeutet
Die Ergebnisse weisen auf eine praxisnahe Reihenfolge hin: Kosten pro erfolgreicher Aufgabe messen, die stärkste Konfiguration ohne Router ermitteln und erst danach prüfen, ob ein Klassifikator sie übertreffen kann. Der Beitrag weist darauf hin, dass die Werte aus Einzelmessungen mit einer Beispieltestsuite stammen und dass Latenzen, Tokenzahlen und abgerechnete Kosten je nach Eingabelänge, Kontext-Caching und Produktionslast variieren. Geschwindigkeitsvergleiche mit dem standardmäßigen Flash oder Pro vermischen die beiden Testrunden und sollten als Näherungswerte gelesen werden. Der Quelltext bricht bei der Auflistung weiterer Einschränkungen ab, darunter ein Durchlauf pro Konfiguration und 50 Eingaben mit von Menschen zugewiesener Schwierigkeit.
Google for Developers: Cost per task: Using cheap classifiers to route across Gemini models and thinking levels- Google Developers Blog