Databricks beschleunigt Abfragen mit UNIQUE-Constraints
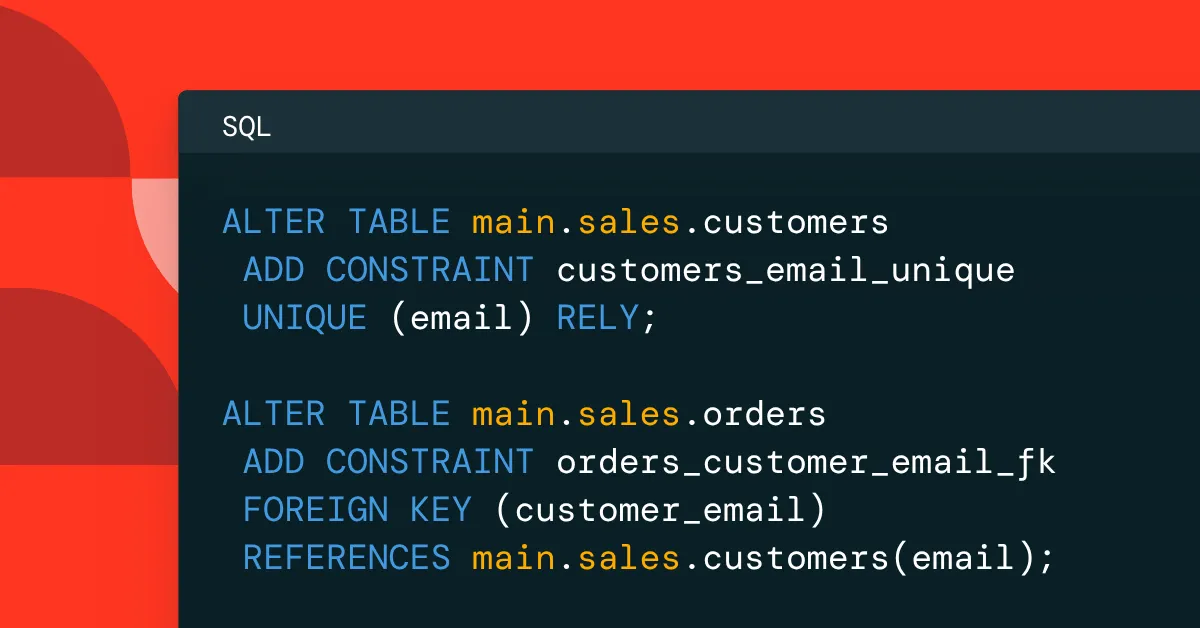
Die neuen UNIQUE-Constraints von Databricks ermöglichen mehrere Eindeutigkeitsgarantien, darunter zusammengesetzte Garantien und Garantien, die NULL-Werte erlauben. Mit der Einstellung RELY kann der Abfrageoptimierer unnötige Joins und Aggregationen überspringen.
- UNIQUE kann mehrere Eindeutigkeitsgarantien festhalten, darunter zusammengesetzte Garantien und Garantien, die NULL-Werte erlauben.
- Die Funktion ist als Public Preview für Unity Catalog Delta tables verfügbar.
- Der Abfrageoptimierer kann Constraints verwenden, die mit RELY markiert sind.
- Im TPC-DS-Test führte das Entfernen des JOIN zu einer 7,9-fachen Beschleunigung.
- Laut Databricks können Abfragen durch die Verwendung von UNIQUE und RELY bis zu 12-mal schneller ausgeführt werden.
Mehrere Eindeutigkeitsgarantien in einer Tabelle
Laut der Ankündigung von Databricks vom 3. November 2026 sind UNIQUE-Constraints als Public Preview für Unity Catalog Delta tables, in Databricks SQL und in Databricks Runtime 18.2 oder höher verfügbar. Die Funktion hält im Schema einer Tabelle die Eindeutigkeitsgarantien fest, die von Prozessen zum Laden von Daten, Quellsystemen oder anderen Verfahren zur Datenqualität gewährleistet werden.
Ein PRIMARY KEY ist der primäre Zeilenbezeichner einer Tabelle, von dem pro Tabelle nur einer definiert werden kann. Seine Spalten dürfen keine NULL-Werte enthalten. UNIQUE beschreibt dagegen zusätzliche Eindeutigkeitsgarantien. In einer Tabelle können mehrere UNIQUE-Constraints definiert werden, und die betroffenen Spalten dürfen NULL-Werte enthalten.
Eine users-Tabelle könnte beispielsweise die Spalte user_id als Primärschlüssel verwenden und zugleich verlangen, dass username, email sowie die Kombination aus workspace_id und external_user_id eindeutig sind. Ein zusammengesetzter UNIQUE-Constraint bedeutet, dass die Kombination der beiden Spalten nicht wiederholt werden darf, auch wenn die einzelnen Werte in mehreren Paaren vorkommen können.
Constraints müssen separat geprüft werden
Wie PRIMARY-KEY- und FOREIGN-KEY-Constraints sind auch UNIQUE-Constraints informativ. Databricks setzt sie beim Schreiben von Daten nicht durch. Ein Ladevorgang mit einem doppelten Wert, der nicht NULL ist, schlägt daher nicht automatisch fehl. Im Gegenzug bewahrt das Schema die Eindeutigkeitserwartung, die auch von Nutzern, Tools und Anwendungen erkannt werden kann.
Ein FOREIGN KEY kann ebenfalls auf einen UNIQUE-Constraint verweisen. Bei einem zusammengesetzten Schlüssel müssen die referenzierten übergeordneten Spalten in derselben Reihenfolge wie in der UNIQUE-Definition aufgeführt werden. Die Spaltennamen dürfen abweichen, Reihenfolge und Datentypen müssen jedoch übereinstimmen. Werden die übergeordneten Spalten nicht angegeben, verweist die Referenz standardmäßig auf den PRIMARY KEY der Tabelle.
Der Standardzustand eines Constraints ist NORELY. In diesem Zustand hält Databricks die Bedeutung des Schemas fest, verwendet sie jedoch nicht für Umschreibungen, die von der Korrektheit der Abfrage abhängen. Databricks empfiehlt, RELY erst zu aktivieren, nachdem die Daten geprüft und die kontinuierliche Pflege der Garantie sichergestellt wurde.
RELY kann die Kosten von Joins senken
RELY prüft vorhandene Daten nicht und schränkt künftige Schreibvorgänge nicht ein. Die Einstellung erlaubt dem Optimierer, die Gültigkeit des Constraints vorauszusetzen. Verstoßen die Daten dennoch gegen eine mit RELY gekennzeichnete Garantie, kann eine darauf basierende Umschreibung der Abfrage falsche Ergebnisse liefern. Die Optimierung ist auf Photon-kompatiblen Rechenressourcen verfügbar.
Databricks zeigt außerdem ein Beispiel, in dem eine gemeinsame View die Tabellen user_events und users verbindet, während ein bestimmtes Dashboard nur Daten aus user_events benötigt. Zusammen können UNIQUE und FOREIGN KEY garantieren, dass jedes Ereignis höchstens eine passende Benutzerzeile hat und dass die Beziehung besteht. In diesem Fall kann der Optimierer die nicht benötigte JOIN-Operation entfernen.
Für den Test wurde der TPC-DS-Datensatz SF10000 verwendet, der eine Größenordnung von 10 Terabyte repräsentiert. Untersucht wurden die Tabelle store_sales mit 28,8 Milliarden Zeilen und die Tabelle customer mit 65 Millionen Zeilen. Mit den als RELY markierten Constraints entfernte Databricks den Join, reduzierte die Menge der verschobenen Daten um mehr als 99,99 Prozent und senkte die mediane Ausführungszeit von 23,6 Sekunden auf 3,0 Sekunden. Das entspricht einer 7,9-fachen Beschleunigung.
Auch DISTINCT kann entfallen
BI-Tools und Abfragegeneratoren fügen Abfragen häufig vorsorglich DISTINCT hinzu, weil ein JOIN doppelte Zeilen erzeugen kann. Sind die ausgewählten Werte bereits eindeutig, entfernt DISTINCT nichts, kann aber trotzdem eine Aggregation und das Verschieben von Daten erfordern. Ein mit RELY markierter UNIQUE-Constraint kann belegen, dass dies nicht nötig ist.
Im Beispiel von Databricks ist user_id in der Tabelle user_identifiers nicht NULL und UNIQUE, während optional_identifier eine UNIQUE-Spalte ist, die ebenfalls NULL-Werte erlaubt. Der Optimierer kann die Eindeutigkeit von user_id zusammen mit der Garantie für nicht NULL verwenden und dadurch die Aggregation entfernen. Laut den 10-Terabyte-Messungen von Databricks mit TPC-DS reduzierte die Verwendung von UNIQUE und RELY das Verschieben von Daten um mehr als 99,99 Prozent und ermöglichte eine bis zu 12-mal schnellere Ausführung von Abfragen.
Die Funktion könnte daher für Teams nützlich sein, die bereits Eindeutigkeitsregeln in ihren Datenpipelines pflegen, diese bisher aber nicht in ihren Tabellenschemata festhalten konnten. Der Leistungsvorteil hängt davon ab, die erklärten Garantien vorab zu prüfen und anschließend kontinuierlich einzuhalten.
Databricks: Declare and optimize with UNIQUE constraints on Databricks