Confluent stellt Streamhouse-Architektur und Lightning Tables für KI-Agenten vor
Confluent, ein IBM-Unternehmen, hat das Streamhouse vorgestellt, eine Datenarchitektur, die KI-Agenten, Anwendungen und Analysen einen kontrollierten, aktuellen Blick auf das Geschäft ermöglichen soll. Dazu macht das Unternehmen Lightning Tables auf AWS allgemein verfügbar und vervollständigt damit die fünf Säulen seiner Data Streaming Platform.
- Confluent, ein IBM-Unternehmen, hat am 4. November 2026 die Streamhouse-Architektur vorgestellt, die den Geschäftskontext für KI-Agenten, Anwendungen und Analysen aktuell halten soll.
- Query wird zur fünften Säule der Data Streaming Platform, neben Stream, Connect, Process und Govern.
- Lightning Tables ist auf AWS allgemein verfügbar und bietet SQL- und API-Zugriff auf Live-Daten aus Kafka.
- Confluents interne Tests zeigen etwa 100 Millisekunden bis zur Bereitstellung, 10 bis 100 Millisekunden Abfragelatenz und über 1.000 Abfragen pro Sekunde.
- Accenture und Extend werden als Kunden genannt, die eine Streamhouse-Architektur einsetzen.
Was Confluent angekündigt hat
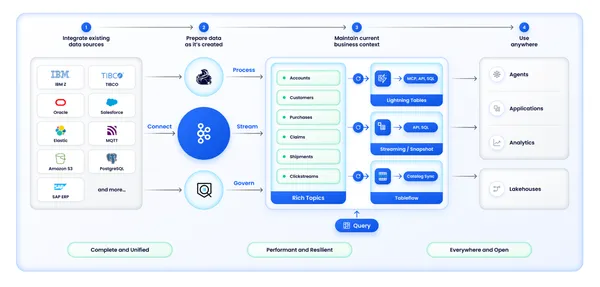
Confluent hat am 4. November 2026 neue Funktionen für den Aufbau eines Streamhouse angekündigt. Das Unternehmen beschreibt es als neuen Typ von Datenarchitektur, der den Geschäftskontext aktuell hält, während KI-Agenten und andere Systeme Entscheidungen treffen und Aktionen ausführen. Laut Confluent erfasst, verarbeitet, steuert und liefert die Architektur fortlaufend den aktuellen Zustand eines Unternehmens.
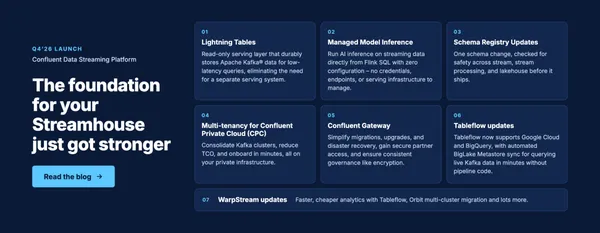
Mit dem Release kommt Query als fünfte Säule zur Data Streaming Platform (DSP) hinzu, neben Stream, Connect, Process und Govern. Confluent zufolge wird die DSP dadurch zu einer vollständigen, einheitlichen Plattform für den Aufbau eines Streamhouse. Das Unternehmen gibt außerdem an, im Zentrum der Datenstrategie von IBM zu stehen und Echtzeit-Datenstreaming mit den Integrations-, Governance- und KI-Fähigkeiten von IBM in Hybridumgebungen zu verbinden.
Das Problem, das das Streamhouse adressiert
Confluent argumentiert, dass Data Lakes, Data Warehouses und Lakehouses vor allem für Reporting oder andere Batch-Jobs konzipiert wurden. Da KI-Agenten immer mehr Aufgaben in Unternehmen übernehmen, müssen sie Entscheidungen auf Basis von Informationen treffen, die über Systeme verteilt sind, welche sich zu unterschiedlichen Zeiten aktualisieren. Widersprechen sich diese Systeme beim aktuellen Stand des Geschäfts, können Agenten auf veralteten oder widersprüchlichen Informationen handeln, und diese Aktionen können sich in andere Workflows fortsetzen.
Das Unternehmen nennt ein anschauliches Beispiel: eine Fluggesellschaft, die mit einem gestrichenen Flug umgeht. Die Flugbetriebssysteme erfassen, wo sich das Flugzeug befindet, die Einsatzplanung, wann es abfliegt, und die Reservierung, welche Sitzplätze frei sind. Weil sich diese Systeme zu unterschiedlichen Zeiten aktualisieren, könnte ein autonomer Umbuchungsagent eine Reiseroute zusammenstellen, die in jedem System gültig aussieht, in der Praxis aber scheitert, etwa wenn ein Sitz frei ist, das Flugzeug aber nicht rechtzeitig zum Anschluss des Passagiers eintrifft.
Mit einem Streamhouse fließt jede Änderung, etwa ein neuer Standort des Flugzeugs, ein verspäteter Abflug oder ein gebuchter Sitz, in einen kontinuierlichen Strom von Ereignissen. Diese Updates werden zu einem aktuellen Geschäftskontext zusammengeführt, den Umbuchungsagenten, Serviceteams und Anwendungen gemeinsam prüfen können, bevor sie eine neue Reiseroute anbieten.
Drei Prinzipien und fünf Säulen
Laut Confluent beruht ein Streamhouse auf drei Prinzipien: aktuell, geschäftskritisch und dezentral. Es hält den Geschäftskontext fortlaufend auf dem neuesten Stand, ist auf Service-Level für den Produktivbetrieb ausgelegt und holt die Daten dort ab, wo sie liegen, ohne dass sie zuvor konsolidiert werden müssen. Es soll neben bestehenden Data Warehouses und Lakehouses funktionieren und eine operative Echtzeitschicht ergänzen.
Das Herzstück der DSP ist Apache Kafka, das Geschäftsereignisse erfasst und streamt. Confluent weist darauf hin, dass Kafka allein es den Teams überlässt, alles Weitere zusammenzubauen, was nötig ist, um Ereignisse in aktuellen Kontext zu überführen. Die fünf Säulen sind:
- Stream: basiert auf Apache Kafka und der Kora-Engine, mit Latenzen unter einer Millisekunde in Confluents internen Tests. Die tatsächliche Latenz variiert laut Unternehmen je nach Konfiguration und Workload.
- Connect: über 150 vollständig verwaltete und individuelle Konnektoren sowie neues Hybrid-Konnektor-Management.
- Process: nutzt Apache Flink, um Daten nahe an der Quelle zu kombinieren und anzureichern, mit zusätzlicher Batch-Ausführung, um Streaming-Workloads aus vorhandenen Daten zu initialisieren.
- Govern: Funktionen für Lineage, Katalog, Qualität, Verschlüsselung, Schema und Zugriffskontrolle.
- Query: liefert aktuellen Kontext über Tableflow für Lakehouses und Warehouses, über die Real-Time Context Engine für KI-Agenten via Model Context Protocol (MCP) und über Lightning Tables für Anwendungen.
Lightning Tables in Confluent Cloud
Lightning Tables ist auf AWS allgemein verfügbar. Confluent beschreibt es als schreibgeschützte Serving-Schicht, die Apache-Kafka-Daten dauerhaft speichert und in Tabellen materialisiert, die bei neuen Änderungen aktuell gehalten werden. Anwendungen erhalten per SQL und API Zugriff mit niedriger Latenz auf den aktuellen Zustand des Geschäfts, was laut Unternehmen den Bedarf verringert, Daten in eine separate Datenbank zu kopieren.
In internen Tests von Confluent liegen laut Unternehmen etwa 100 Millisekunden zwischen der Entstehung neuer Daten und ihrer Bereitstellung, die Abfragelatenz beträgt 10 bis 100 Millisekunden und der Durchsatz über 1.000 Abfragen pro Sekunde. Weitere genannte Funktionen:
- Eine vollständig verwaltete Serving-Schicht ohne separate ETL-Pipelines, Datenbanken oder Caches.
- Abfragen per SQL und über eine direkte API.
- Schemas, Lineage und Zugriffsrichtlinien, die von der Erfassung bis zur Bereitstellung gelten.
- Verwaltung der Schema-Evolution, um Brüche in nachgelagerten Anwendungen zu vermeiden.
- Ein Feature Store, um Features in Flink zu berechnen und für maschinelles Lernen zu speichern, auch für Echtzeit-Personalisierung.
Kundenberichte und Einordnung
Confluent nennt zwei Kunden. Accenture, das in mehr als 120 Ländern tätig ist, sagt, der Wechsel zu einer von Confluent betriebenen Streamhouse-Architektur entkopple Datenproduzenten von Datenkonsumenten. Thomas Mahaffey, SAI Chief Data Strategist bei Accenture, sagte, das Fundament habe „unsere Time-to-Insight von Monaten auf Tage gesenkt“ und unterstütze KI für die 800.000 Beschäftigten des Unternehmens.
Extend, eine KI-native Commerce-Plattform, gibt an, eine zu 100 Prozent serverlose Streamhouse-Architektur auf Confluent Cloud zu betreiben. Jonathan Kropp, Director of AI and Architecture, sagte, das Setup „macht Kafka zu unserer operativen Single Source of Truth“ und ermögliche es nachgelagerten Microservices, Echtzeitdaten zu konsumieren und abzufragen.
Für Unternehmen, die agentenbasierte Systeme aufbauen, positioniert die Ankündigung Streaming-Daten als gemeinsame Quelle für aktuellen Kontext statt als Datenstrom, der in separate Speicher kopiert wird. Die Leistungsangaben stammen aus Confluents eigenen Tests, die Ergebnisse im Produktivbetrieb hängen daher von Konfiguration und Workload ab. Die Verfügbarkeit von Lightning Tables wird derzeit nur für AWS genannt.